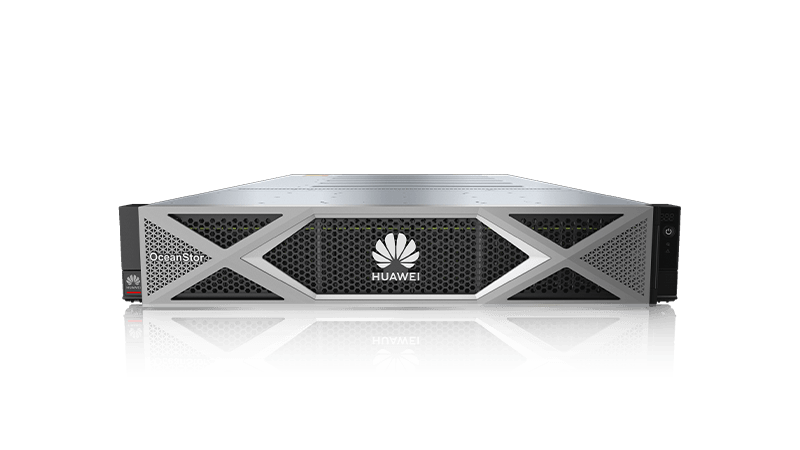
OceanStor A600 AI Inference Storage
Akcelerace LLM inference, RAG architektury a Key-Value Cache v 2U provedení
Kompaktní 2U AI úložiště nové generace navržené speciálně pro fázi AI inference a obsluhování modelů (LLM serving). Díky unikátní architektuře pro odlehčení paměti GPU ukládáním KV-Cache do rychlého flash pole snižuje Time-To-First-Token (TTFT) až o 78% a zvyšuje propustnost generování tokenů o 60%.
Technické specifikace & parametry
Vysoká hustota IOPS v 2U formátu pro nízkou latenci a maximální souběžnost uživatelů
Stáhnout solution brief (PDF)Výkon & Hustota
- Formát šasi 2U / 2 uzly (High-Density)
- Šířka pásma Až 160 GB/s na 2U box
- IOPS > 3 600 000 IOPS
- Latence odpovědi < 0,5 ms
Akcelerace AI Inference
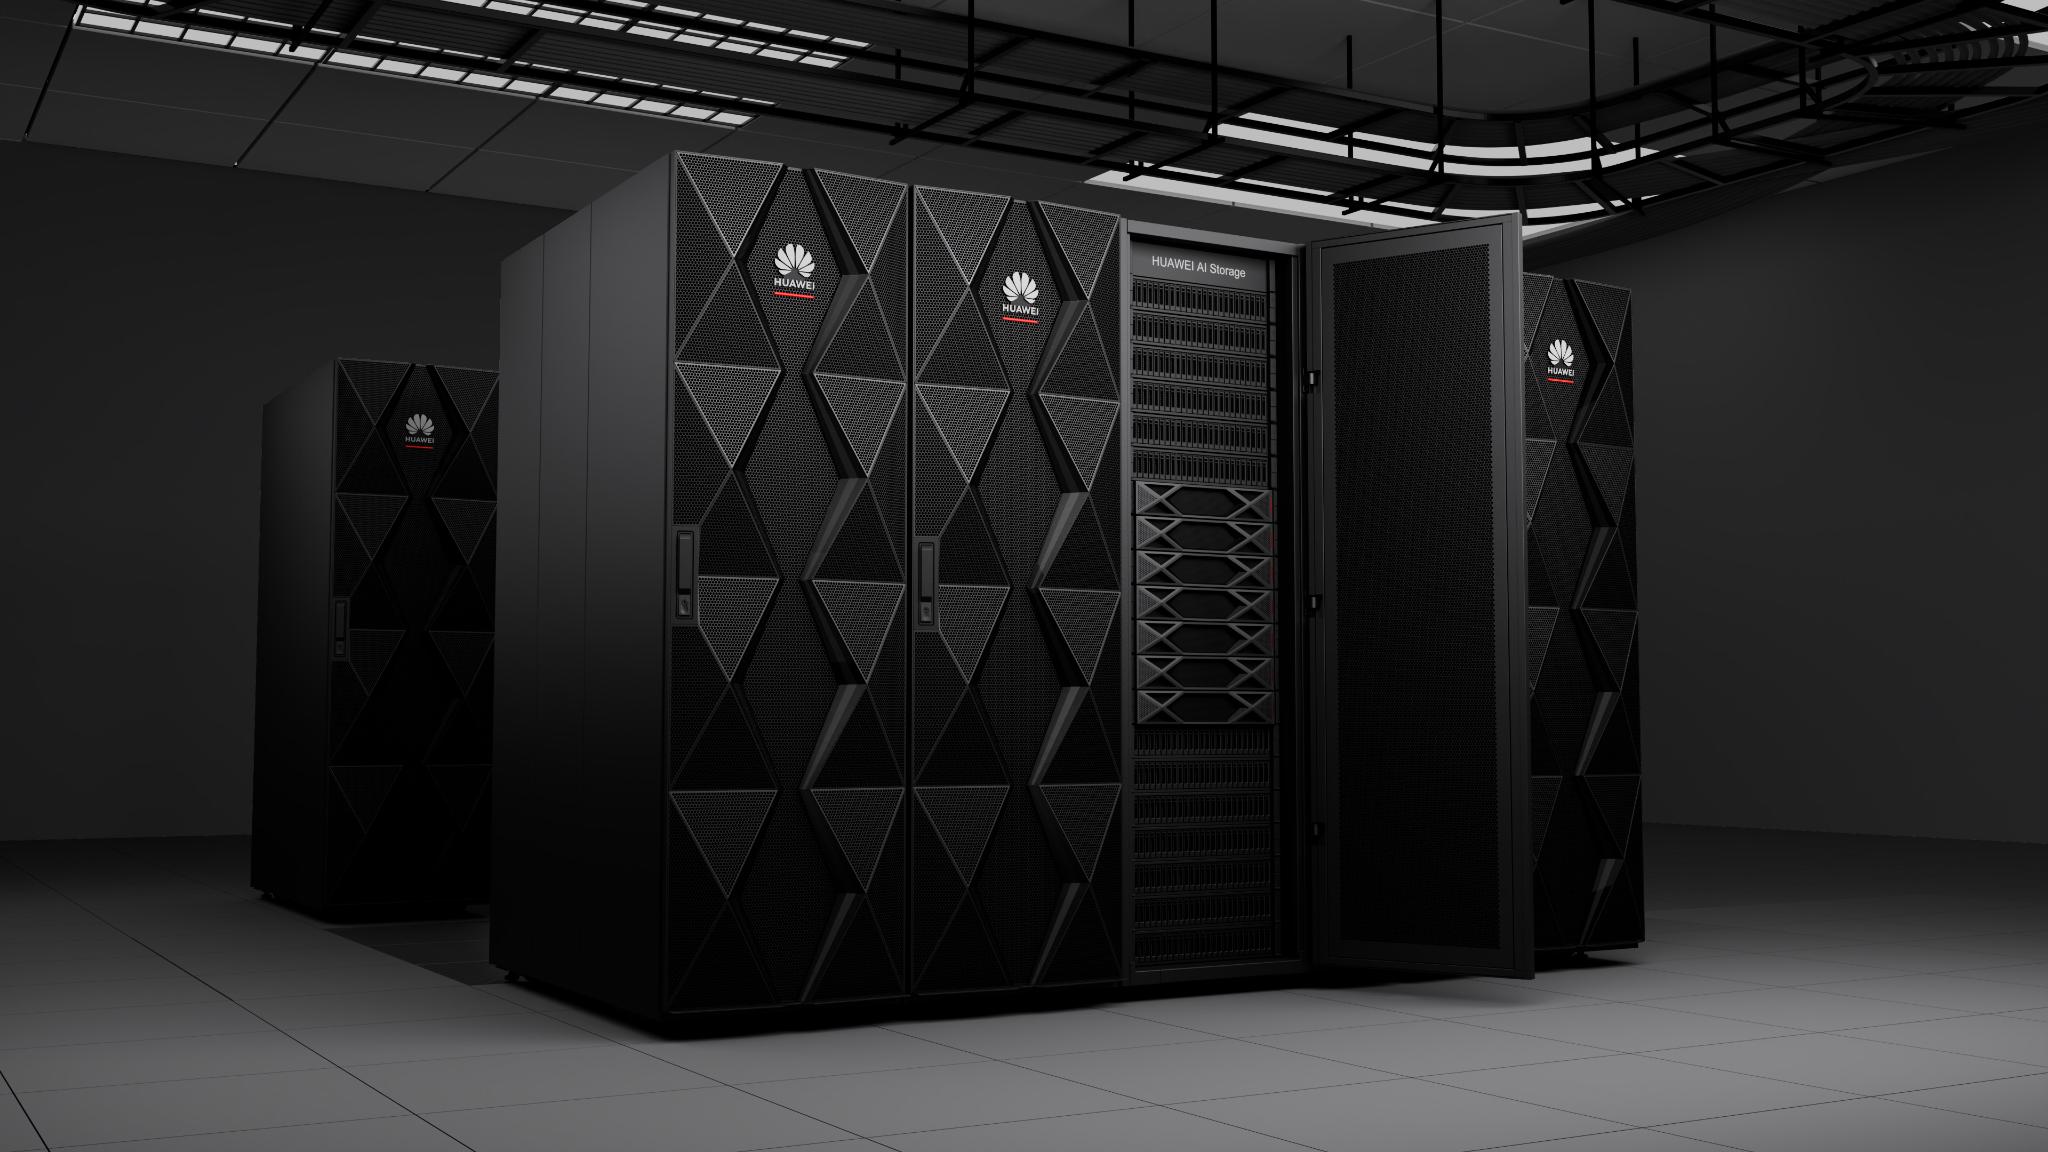
- KV-Cache Offload Hardwarově řízená NVMe mezipaměť
- Zkrácení TTFT -78% (okamžitá odezva)
- Propustnost tokenů +60% generovaných tokenů/s
- Near-Storage Compute Filtrování & embedingy na disku
Úložná kapacita & Disky
- Kapacita disků Až 36x palm-sized NVMe SSD
- Kapacita v 2U Až 2,2 PB raw v 2U
- Škálovatelnost Až 128 nodů v clusteru
- Datová redukce Inline deduplikace & komprese
- Nástupce za A310 Vyšší hustota & akcelerace inference
Síť & Konektivita
- Protokoly sítě 100/200/400GE RoCEv2, InfiniBand
- Přístupová rozhraní POSIX, NFS v3/v4, SMB, S3
- GPU / NPU vazba NVIDIA GPUDirect, Ascend CANN
- Zabezpečení MRP Ransomware Shield, AES-256
Ideální scénáře nasazení OceanStor A600
Navrženo pro produkční provoz podnikového AI v lokálních datacentrech ČR a SR
LLM Serving & Firemní asistenti
- Blesková obsluha uživatelských dotazů bez čekání na první token
- Ukládání kontextu dlouhých konverzací a systémových promptů do KV-Cache
- Eliminace potřeby dokupovat drahé servery pouze pro rozšíření GPU VRAM
- Multi-tenantní oddělení oddělení s garantovanou QoS prioritou
RAG & Vektorové vyhledávání
- Okamžité načítání souvislostí z firemních znalostních bází (Confluence, Jira, ERP)
- Paralelní prohledávání milionů embeddingů s minimální latencí
- Nativní integrace s Milvus, Qdrant, ChromaDB a LangChain frameworky
- Bezpečné lokální uložení citlivých firemních dat bez odesílání do cloudu
Finanční analytika & Fraud Detection
- Real-time scoring platebních transakcí v milisekundových SLA oknech
- Průběžná evaluace rizikových modelů pro banky a pojišťovny
- Plný soulad s regulatorními požadavky DORA a ČNB/NBS na auditovatelnost
- Aktivní-aktivní zrcadlení pro nepřetržitý provoz bez výpadku
Zdravotnictví & Edge Inference
- AI vyhodnocování snímků z magnetické rezonance, CT a mamografie v reálném čase
- Lokální kompaktní nasazení v nemocničních serverovnách s minimálním hlukem a spotřebou
- Šifrování citlivých pacientských dat v klidu i při přenosu (GDPR compliance)
- Vysoká hustota: plný výkon inference clusteru v pouhých 2U
Vyzkoušejte akceleraci AI inference na vlastních datech a modelech
Změříme zrychlení vašich LLM a RAG modelů s OceanStor A600 přímo na vašich testovacích datasetech. Poskytneme sizing i zápůjčku techniky.