Huawei AI Data Lake Solution
Komplexní podniková infrastruktura pro správu životního cyklu AI dat
Komplexní systémové řešení integrující sběr dat (Ingest), přípravu a čištění (Curation), trénování modelů (Training) i produkční obsluhu (Inference). Spojení distribuovaného souborového systému OceanFS, inteligentního Unified Cache Manageru (UCM) a globální orchestrace Omni-Dataverse zvyšuje propustnost datových pipeline 22× a eliminuje prostoje drahých výpočetních GPU clusterů.
Klíčové technologické pilíře
Harmonické propojení hardwarové propustnosti a inteligentního software
Stáhnout solution brief (PDF)Propustnost & Akcelerace
- Akcelerace I/O s UCM Až 22× vyšší propustnost
- Redukce latence (OceanFS) -90% latence přístupu
- Využití GPU výpočtů > 90% (konec GPU starvation)
- Podpora fabric sítí 400GE RoCEv2, InfiniBand, GDS
Data Fabric & Orchestrace
- Omni-Dataverse Globální jednotný jmenný prostor
- Protokolová konvergence Zero-Copy mezi S3, NFS a POSIX
- Metadata Engine Distribuovaný, 100B+ souborů
- Automatizovaný Tiering Dle teploty dat (NVMe → SSD → HDD)
Integrované vrstvy hardware
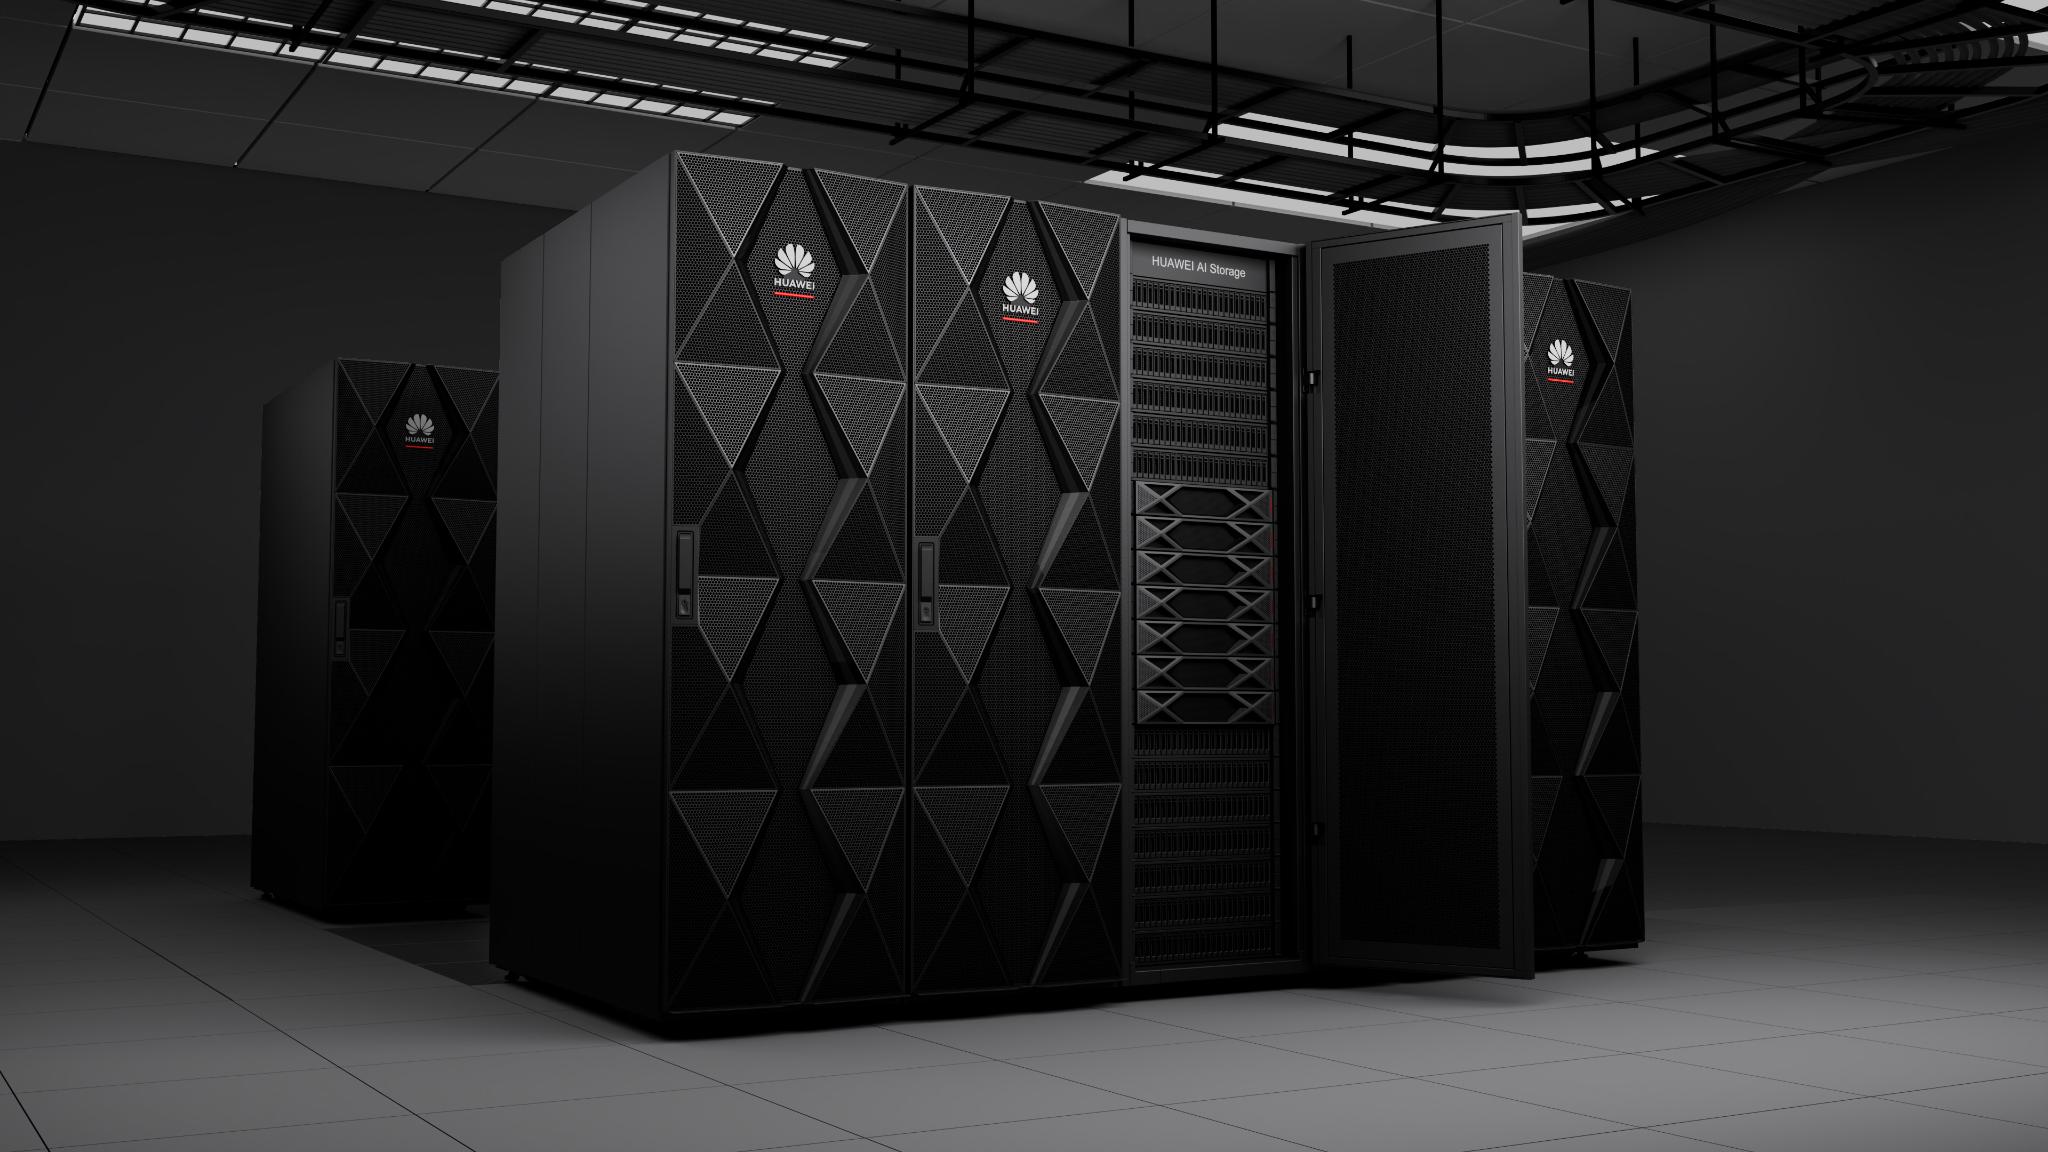
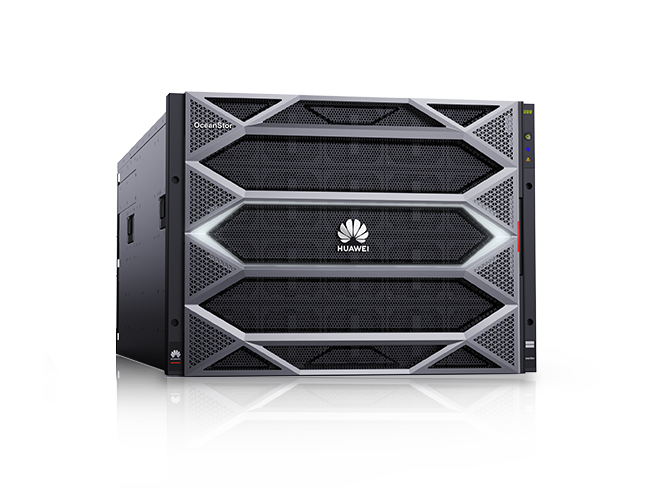
- Tréninková vrstva OceanStor A800 / Pacific 9928
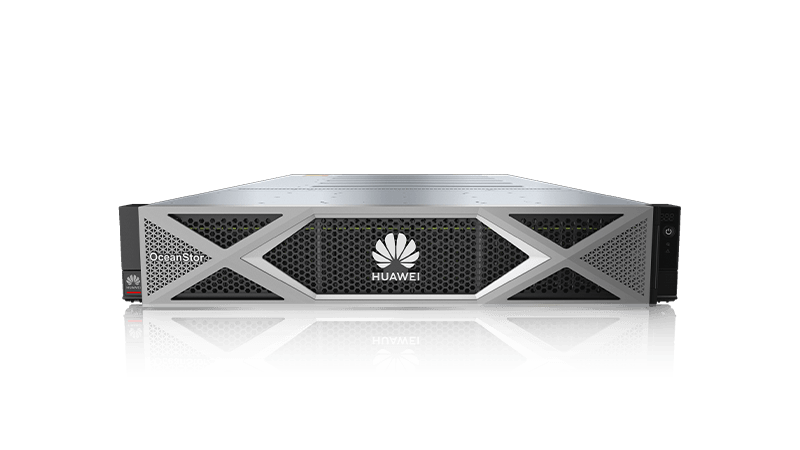
- Inference vrstva OceanStor A600 (KV-Cache)
- Kapacitní vrstva OceanStor Pacific 9550 / 5310
- Záloha & Trezor OceanProtect X8100 / X9100
Bezpečnost & Regulace
- Ochrana před ransomware Huawei MRP (detekce 99,99%)
- Offline trezor Air Gap se samostatným odpojením
- Neměnnost korpusu WORM HyperLock auditní stopa
- Soulad se standardy EU AI Act, NIS2, DORA
Životní cyklus AI dat v praxi
Jak AI Data Lake řeší reálné produkční výzvy moderních organizací
1. Hromadný sběr surových dat (Ingest)
- Průběžné nahrávání nestrukturovaných dat ze senzorů, kamer, webu i ERP
- Nativní rozhraní S3 Object Storage a NFS bez konverzních prodlev
- Zajištění integrity a neměnnosti vstupních primárních datových sad
- Automatická katalogizace a indexace metadat v reálném čase
2. Filtrace & Kurátorství (Curation)
- Čištění, tokenizace a deduplikace rozsáhlých trénovacích korpusů
- Zpracování probíhá přímo nad datovým jezerem (Zero-Copy Data Pipelines)
- Zamezení vytváření duplicitních kopií šetří až 60% diskového prostoru
- Příprava datasetů ve formátech Parquet, TFRecord, Arrow a WebDataset
3. Masivní trénování (Model Training)
- Paralelní krmení GPU nodů přes 400GE RoCEv2 a NVIDIA GPUDirect Storage
- Zkrácení checkpoint zápisů ze 45 minut na méně než 2 minuty
- Automatický přechod do tréninku bez manuálního přesouvání souborů
- Nepřetržitý běh i v případě selhání jednotlivých diskových šasi
4. Nasazení, Inference & Archiv
- Export modelových vah do kompaktního inference clusteru OceanStor A600
- Sdílená mezipaměť kontextu dotazů (KV-Cache) pro rychlé RAG vyhledávání
- Dlouhodobá automatická archivace starších verzí modelů na Pacific 9550
- Záloha s neměnným Air Gap trezorem chráněným před kybernetickými útoky
Konzultujte podnikovou AI architekturu s našimi inženýry
Pomůžeme vám navrhnout ucelené datové jezero od surového ingestu až po GPU clustery. Možnost technické konzultace a PoC testování v ČR.